Bloquear a la IA en robots.txt: qué cambia y qué hace Panamá
Las grandes empresas de IA acordaron una misma línea en robots.txt para que los sitios digan si aceptan que su contenido entrene modelos. Antes de copiarla, conviene entender la diferencia entre entrenar y citar. Y mirar qué hicieron los medios panameños.
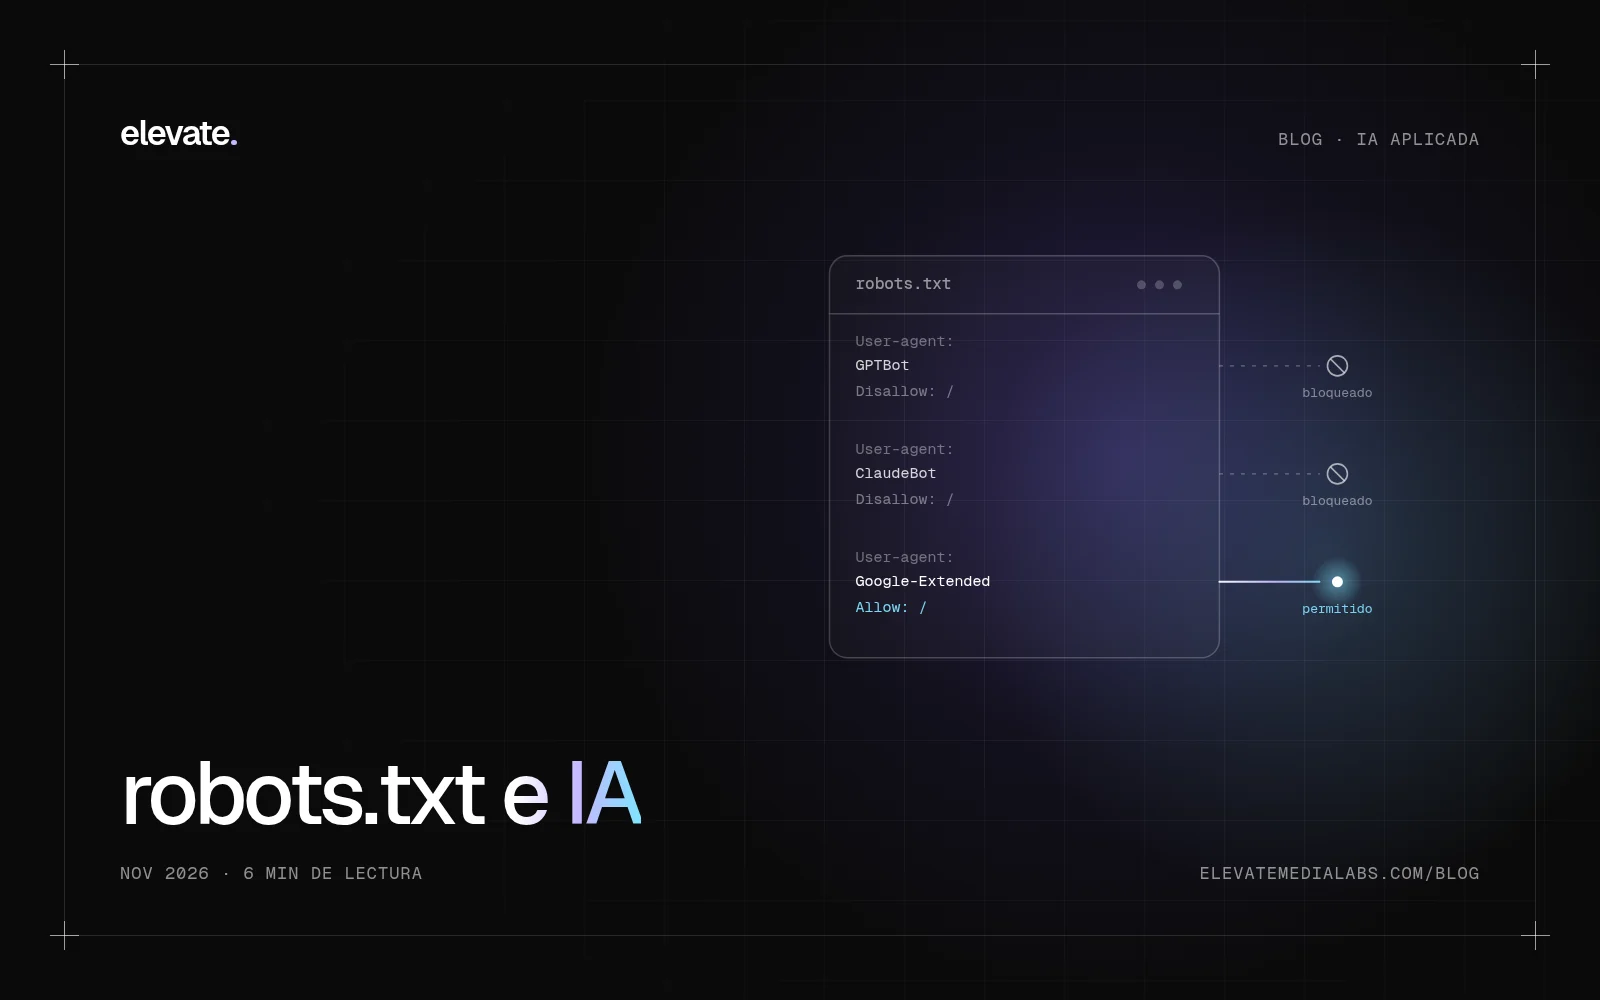
El 30 de octubre pasó algo poco común: OpenAI, Google, Microsoft y Anthropic se pusieron de acuerdo. Las cuatro dijeron que van a respetar una misma señal en el archivo robots.txt para que cualquier sitio web pueda decir "no quiero que mi contenido se use para entrenar IA", sin tener que escribir una regla distinta para cada empresa (The Verge, OpenAI).
Suena a detalle técnico, pero toca una decisión que muchas marcas y medios van a querer tomar rápido: bloquear a la IA. Y ahí hay una trampa. Bloquear el entrenamiento no es lo mismo que desaparecer de ChatGPT o Gemini, y confundir las dos cosas puede costar visibilidad justo donde hoy la gente pregunta por marcas.
01Qué se anunció exactamente
La propuesta la presentó Kevin Kelley, de Anthropic, ante el grupo de trabajo de preferencias de IA de la IETF, el organismo que define muchos estándares de internet. Es un borrador individual, no un estándar aprobado: la propia IETF aclara que un borrador así no tiene peso formal todavía.
La idea es simple. En vez de nombrar a cada bot, el sitio escribe un grupo con un nombre común:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Ese ejemplo, tomado del borrador, dice "no al entrenamiento en todo el sitio, salvo la carpeta de prensa". No bloquea a nadie de rastrear: expresa una preferencia sobre el uso.
Los plazos no son iguales para todos. Según Search Engine Journal, OpenAI lo implementará "en los próximos meses", Google y Microsoft el año que viene (Microsoft desde el 1 de febrero de 2027) y Kevin Kelley escribió a la lista de la IETF que Anthropic empezó a desarrollarlo y que llevarlo a todos sus servicios tomará tiempo. Las versiones no coinciden: The Verge presenta a Anthropic como si ya la hubiera adoptado; SEJ, en cambio, dice que según los plazos informados ninguna de las tres empresas la soporta todavía y que, al 30 de octubre, Anthropic no había publicado nada en su sala de prensa. Meta expresó apoyo, pero no dijo si lo va a respetar.
02Entrenar no es lo mismo que citar
Esta es la parte que importa para una marca. Las empresas de IA usan tu sitio de dos formas distintas:
- Para entrenar el modelo. Tu contenido entra en lo que el modelo "aprende" y queda incorporado, sin enlace ni crédito.
- Para buscar y citar. Cuando alguien hace una pregunta, el asistente sale a buscar, lee páginas y las enlaza en su respuesta.
La nueva señal habla de lo primero. OpenAI, por ejemplo, ya separaba sus bots: GPTBot para entrenamiento y OAI-SearchBot para búsqueda, y dice que esos controles seguirán vigentes. Microsoft va a ofrecer dos preferencias separadas, una para entrenamiento y otra para grounding, es decir, para que tu página sirva de fuente en una respuesta, y aclara que tu sitio seguirá en Bing igual. Google, según SEJ, tratará la nueva señal como un bloqueo de Google-Extended, que además de entrenamiento cubre el uso en respuestas de Gemini.
Traducido: con la misma línea, una empresa puede quedar fuera de un uso y otra de dos. No es un interruptor único.
03El dato que faltaba: qué hacen los medios de Panamá
Para saber dónde está el país, revisamos el robots.txt público de 20 sitios de medios panameños el 2 de noviembre de 2026. Pudimos leer el de 16; tres no respondieron y uno bloquea las descargas automáticas. Buscamos reglas para los bots de IA más conocidos: GPTBot, OAI-SearchBot, ChatGPT-User, Google-Extended, ClaudeBot, anthropic-ai, CCBot y PerplexityBot.
Solo uno de los 16 tiene reglas para bots de IA. Destino Panamá bloquea a GPTBot, ChatGPT-User y CCBot, que es el rastreador de Common Crawl, una base muy usada para entrenar modelos. Los otros quince, entre ellos La Prensa, La Estrella de Panamá, Crítica, TVN, Telemetro, Panamá América, Metro Libre, Mi Diario, Eco TV, En Segundos y Newsroom Panama, no tienen reglas para ninguno de esos bots. En la práctica, eso significa que los dejan pasar.
Es una foto de un día y de una lista acotada, y cualquiera puede repetirla: basta con abrir dominio.com/robots.txt. Pero dice algo claro: en Panamá, la conversación sobre bloquear a la IA casi no ha llegado a los archivos de los medios. Con una señal común que se escribe en tres líneas, eso puede cambiar rápido.
Hay un detalle en el caso de Destino Panamá. Bloquear ChatGPT-User, el bot que visita una página cuando un usuario se lo pide a ChatGPT, va más allá del entrenamiento: afecta la posibilidad de que ChatGPT lea esa página en el momento de responder.
04Por qué es un tema de reputación
Lo que la IA lee decide lo que dice de tu marca, y en español los asistentes citan mucho el contenido de las propias marcas porque hay poca capa editorial. Si los medios panameños empiezan a bloquear, la IA tendrá menos prensa local para describir empresas, instituciones y crisis. Si las marcas bloquean sin distinguir, se sacan a sí mismas de las respuestas.
Hay razones legítimas para no querer entrenar modelos ajenos, sobre todo si tu contenido es tu producto, como en un medio, un estudio o una base de datos. Pero para la mayoría de las marcas, el riesgo hoy no es que la IA las lea demasiado: es que no las lea.
05Qué decidir antes de tocar el robots.txt
- Separa los dos usos. Pregúntate por separado si te importa que tu contenido entrene modelos y si te importa aparecer citado en las respuestas. Las respuestas pueden ser distintas.
- Revisa lo que ya tienes. Abre tu
robots.txty el de tu proveedor de hosting o de seguridad: algunos servicios ya bloquean a bots de IA por defecto sin que lo hayas decidido. - No uses la señal común como bloqueo total. Está pensada para el entrenamiento. Si quieres seguir en las búsquedas con IA, no bloquees los bots de búsqueda, como
OAI-SearchBot, ni el acceso en vivo, comoChatGPT-User. - Protege lo que quieres que se cite. El ejemplo del borrador deja abierta la carpeta de prensa. Tu página de servicios, tu sala de prensa y tus guías son lo que quieres que la IA encuentre.
- Mide antes y después. Haz las preguntas que haría tu cliente en varios asistentes y registra si apareces. Si cambias el
robots.txt, repite la medición unas semanas después. Es el tipo de seguimiento que hacemos en nuestros servicios de inteligencia de medios.
06Lo que nos llevamos
La señal común es una buena noticia: por primera vez, decir que no al entrenamiento será una sola línea y no una lista de nombres que cambia cada mes. Pero no es un botón para "salir de la IA", y usarla así sería un error de reputación. La decisión correcta no es bloquear o no bloquear. Es elegir qué uso permites, para qué contenido, y medir qué pasa con tu visibilidad.
07Preguntas frecuentes
¿Bloquear a la IA en robots.txt me saca de ChatGPT o Gemini?
No necesariamente. La señal común __usage_ai-training expresa una preferencia contra el entrenamiento de modelos, no contra la búsqueda ni las citas. En OpenAI, los bots de búsqueda (OAI-SearchBot) y de acceso en vivo (ChatGPT-User) se controlan aparte. En Google, en cambio, la señal se tratará como un bloqueo de Google-Extended, que también cubre el uso en respuestas de Gemini.
¿Qué es la señal común __usage_ai-training?
Es un grupo de robots.txt propuesto por Kevin Kelley, de Anthropic, en un borrador individual de la IETF publicado el 30 de octubre de 2026. Permite decir con una sola regla si un sitio acepta que su contenido entrene modelos de IA generativa, sin escribir una regla por cada empresa. No es un estándar aprobado.
¿Cuándo empiezan a respetarla las empresas de IA?
OpenAI dice que la implementará en los próximos meses; Google apunta a 2027 y Microsoft empezará el 1 de febrero de 2027. Sobre Anthropic hay versiones distintas: The Verge la presenta como ya adoptada y SEJ dice que todavía está en desarrollo.
Fuentes
- The Verge, The biggest names in AI are backing a new way to opt out of scraping (30 de octubre de 2026)
- OpenAI, Making it easier for websites to express AI training preferences (30 de octubre de 2026)
- IETF, draft-kelley-aipref-training-preference-signal-00 y grupo de trabajo AI Preferences
- Search Engine Journal, Google, Microsoft & OpenAI Plan To Honor Shared AI Training Opt-Out (1 de noviembre de 2026)
- Revisión propia de los archivos
robots.txtpúblicos de 16 medios panameños, 2 de noviembre de 2026